성능 수치 공개
홍보 문구가 아니라 성적표입니다 — 무엇을, 어떻게 재서, 몇 점이 나왔는지, 그리고 한계는 무엇인지 전부 적습니다. 최종 갱신 2026-09-07.
바로문서는 추측하지 않습니다 — 확실하지 않은 값은 비워 두고 노란색으로 표시합니다. 위 "판독 불가" 2장이 그 원칙의 기록입니다.
CORD-v2 (영수증 100장)
네이버 클로바 제작 공개 데이터셋 · 측정일 2026-09-04
| 지표 | 값 | 뜻 |
|---|---|---|
| 정답 값 회수율 (recall) | 94.5% | 정답지에 적힌 값(품목·수량·단가·합계) 중 우리 결과에 들어 있는 비율 |
| 값 F1 | 0.80 | 회수율과 정밀도의 조화평균 — 자체 채점 기준(아래 방법 참조) |
| 처리 완료 | 100 / 100장 | 전 문서 처리 완료 — 이 중 2장은 값을 지어내는 대신 '판독 불가'로 표시 |
| 평균 처리 시간 | 15.3초/장 | 실서비스와 같은 설정으로 측정 |
측정 방법 — 그대로 재현할 수 있게 적습니다
- 표본: CORD-v2 시험(test) 분할의 앞 100장 — 고르지 않고 순서대로 고정해, 누구든 같은 표본으로 재현할 수 있습니다.
- 실행: 실서비스와 동일한 판독 설정으로 처리했습니다. 이 시험을 위한 별도 조정이나 사전 학습은 없습니다.
- 채점: 정답지의 값(품목명·수량·단가·합계 등)이 우리 결과 어딘가에 있으면 회수로 인정하는 값 기준 채점입니다. 숫자는 표기 차이(쉼표·통화 단위)를 같게 취급합니다.
- 제외 없음: 100장 전부 집계에 넣었습니다. 심하게 흐린 2장은 판독이 불가능했는데, 이때 값을 지어내는 대신 "판독 불가"로 표시한 것이 우리 방식입니다.
정밀도 66.8%의 내역 — 감점된 값은 무엇이었나
우리가 낸 값 1,660개를 정답지와 하나씩 대조했습니다(2026-09-06, 같은 100장·같은 결과 파일·추가 처리 없음). 정답지에 근거가 없는 값은 516개(31.1%)였고, 종류별로 나누면 다음과 같습니다.
| 감점된 값의 종류 | 건수 | 우리 값 전체 대비 |
|---|---|---|
| 열 제목·결제 라벨 글자(예: Sub Total, Cash, Change, Tax) | 255 | 15.4% |
| 매장 정보·머리말·꼬리말(상호·주소·감사 문구) | 32 | 1.9% |
| 정답지에 없는 결제 요약 숫자(소계·거스름돈 등 — 원본 대조 결과 일부는 실제 오독) | 7 | 0.4% |
| 채점 방식 차이 — 값 병합·숫자 표기(소수점·통화 기호) | 32 | 1.9% |
| 자동 분류에 걸리지 않은 잔여 값 | 190 | 11.4% |
잔여 190개는 사람이 하나씩 검토했습니다. "판독 불가"라고 우리가 정직하게 남긴 표시가 48개, 다른 언어의 결제 라벨·장식선·설문 항목이 63개, 상호와 분류명(예: BEVERAGES) 등 정답지 범위 밖 글자가 62개였고, 품목명 형태의 값 14개와 숫자 3개가 남았습니다. 여기에 위 표의 숫자 범주(결제 요약 7·숫자 표기 14)를 원본 사진과 대조하니 합계·거스름돈을 잘못 읽은 값이 실제로 섞여 있었습니다(예: 한 장에서 합계 60,500을 49,500으로). 이를 합쳐 오독이나 결함으로 볼 만한 후보는 약 25개, 전체의 1.5% 안팎입니다(같은 단어를 반복해 낸 결함 1건 포함). 정답지 범위 밖 값을 제외하고 다시 계산하면 정밀도는 약 84%가 되지만, 이는 가정에 따른 수치라 위 표의 실측치를 기준으로 봐 주세요.
한 장으로 보면 — 시험 분할 첫 장(#000)
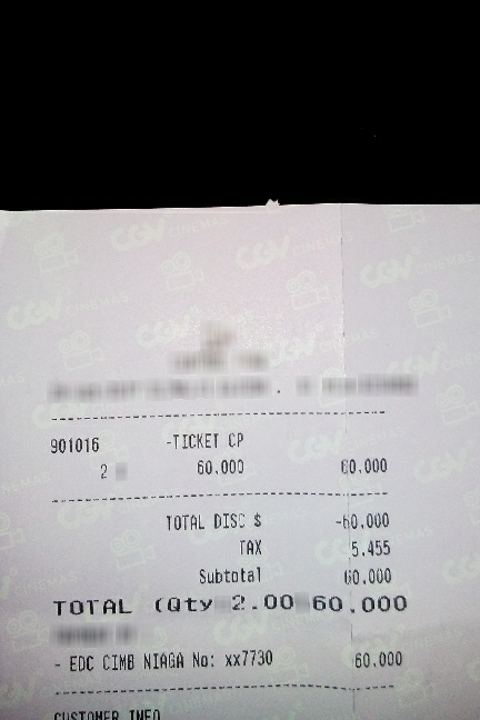
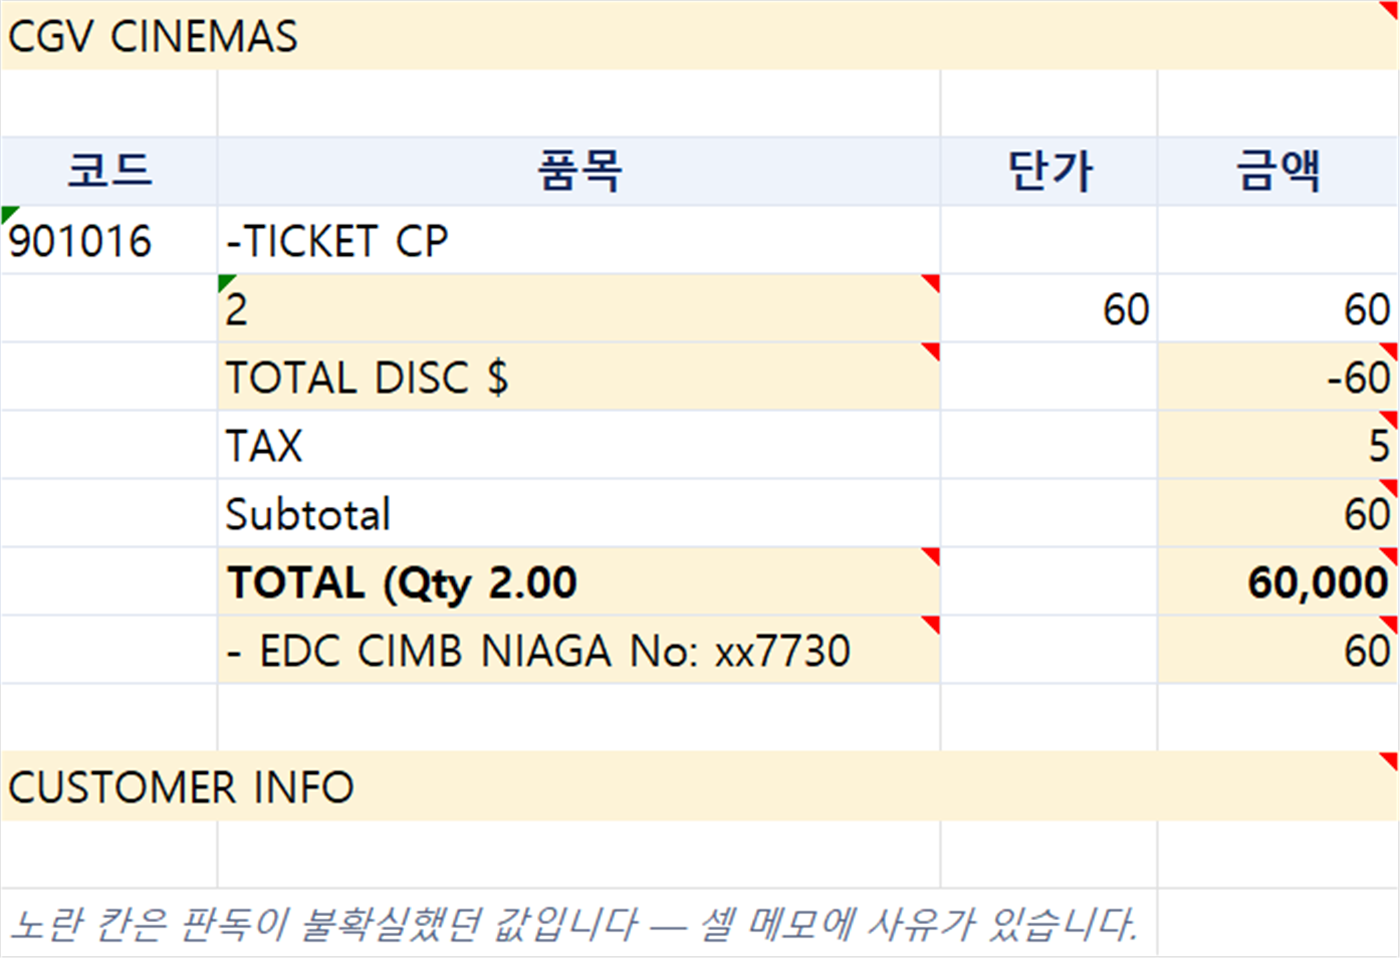
정답지 쪽에서 보면 — 정답지가 묻는 값 11개(품목 코드·품목명·수량·단가·금액·할인·세금·소계·합계 등)는 11개 전부 회수했고, 정밀도는 65%입니다. 감점된 6개는 TOTAL DISC·TAX·Subtotal 같은 라벨, 상호(CGV CINEMAS), 카드 승인 줄, CUSTOMER INFO 안내 문구 — 원본에 그대로 인쇄된 글자인데 정답지가 묻지 않았을 뿐입니다.
두 그림을 나란히 놓고 보면 알 수 있는 것은 하나입니다 — 영수증에 인쇄된 글자가 Excel에 그대로 들어 있다는 것. 사진 한 장을 통째로 옮겨 적는 것이 이 서비스의 목적이라 상호·라벨·안내문도 결과에 있어야 하고, 정답지가 그것을 묻지 않아 정밀도가 깎이더라도 우리는 빼지 않습니다. 실제로 잘못 읽은 값(위 표의 1.5%)은 별개의 문제이며, 그 자리는 결과 파일에서 노란색으로 표시하는 것이 원칙입니다.
읽는 법: CORD 정답지는 품목·수량·금액·합계 필드만 담고, 바로문서는 문서 전체(매장 정보·결제 방식·안내문까지)를 복원합니다. 그래서 "정답지에 없는 값"의 대부분은 틀린 값이 아니라 정답지가 묻지 않은 값입니다. 다만 이 판단도 우리가 한 것이므로, 위 표는 그대로 검증받기 위해 공개합니다.
참고 비교 — 단, 채점 자가 다릅니다
CORD 공식 채점(구조까지 재는 방식) 기준으로, 이 데이터셋의 훈련 문서 800장으로 학습된 전용 판독기 Donut(네이버 클로바)은 F1 0.841을 공표하고 있습니다. 우리의 값 F1 0.80은 다른 채점 방식의 수치이므로 두 숫자로 우열이나 동급을 주장할 수 없습니다 — 규모감을 가늠하는 참고로만 봐 주세요. 공식 채점 방식으로 다시 측정한 결과를 별도로 공개할 예정이며, 그전까지 이 페이지는 비교 결론을 내리지 않습니다.
한계 — 먼저 말씀드립니다
- CORD는 영어·인도네시아어 영수증 위주입니다. 우리의 주 무대인 한국어 촬영 문서와는 조건이 다르며, 한국어 실문서 수치는 자체 검증 데이터 기준으로 준비해 이 페이지에 추가할 예정입니다.
- 정밀도(우리가 낸 값 중 정답지에 있는 비율)는 66.8%로 회수율보다 낮습니다. 그 내역을 값 하나하나 정답지와 대조해 아래 "정밀도 66.8%의 내역"에 공개했습니다 — 대부분은 정답지가 담지 않는 종류의 값이고, 실제 오독으로 볼 만한 값은 전체의 1.5% 안팎입니다.
- 공식 채점 방식(구조 기준)으로의 동일 조건 비교는 추후 별도로 진행해 결과를 여기에 공개합니다.
자주 묻는 질문
영수증 사진을 얼마나 정확하게 복원하나요?
공개 데이터셋 CORD-v2 100장 기준 정답 값의 94.5%를 회수했습니다. 실서비스에서는 판독이 불확실한 값을 노란색으로 표시해, 확인해야 할 곳을 알려드립니다.
읽지 못한 문서는 어떻게 되나요?
값을 지어내지 않습니다. 판독이 안 되면 안 된다고 표시하고, 처리에 실패한 페이지는 자동으로 돌려드립니다.
왜 회사가 직접 잰 수치를 믿어야 하나요?
믿으라고 요구하지 않습니다 — 대신 검증할 수 있게 공개합니다. 표본 선정(공개 데이터셋 시험 분할 앞 100장 고정)·채점 기준·제외 없음 원칙을 전부 적어 두었고, 표본 목록·장별 점수·감점된 값 1,660개의 분류표까지 원자료 파일로 공개합니다(장별 점수 scores.csv · 값 분류 value_breakdown.csv).
숫자가 아니라 실물이 궁금하시면 — 구김·손글씨·도장이 있는 문서 10종의 변환 결과를 원본 사진과 나란히 실은 변환 사례 페이지를 봐 주세요.
내 문서로 직접 확인하기 — 첫 5페이지 무료회원가입도 로그인도 없습니다 · 원본은 받으신 뒤 1시간에 삭제됩니다